
Ces dernières années, nous avons assisté à d’immenses progrès dans les solutions d’intelligence artificielle capables de traiter le langage, l’image ou la voix. Cependant, la majeure partie de l’information où réside la véritable valeur économique d’une entreprise ne se trouve ni dans les textes ni dans les photos, mais dans quelque chose de bien plus prosaïque : les tableaux de données. Nous parlons ici de feuilles de calcul, de bases de données, de fichiers clients, d’historiques de ventes, d’opérations ou de risques de crédit. L’ensemble de ces informations est généralement consigné dans des tableaux de données, organisés en lignes et colonnes, qui soutiennent les décisions quotidiennes de toute organisation. Appréhender correctement le comportement de ces données représenterait un avantage concurentiel majeur : c’est précisément l’objectif des modèles d’IA connus sous le nom de TFM (Tabular Foundation Models). Il s’agit de la nouvelle révolution de l’IA d’entreprise.
Les TFM, ou Tabular Foundation Models, constituent une nouvelle génération d’intelligence artificielle conçue non pas pour maîtriser le langage naturel, mais pour traiter efficacement les données structurées organisées en tableaux. Les modèles de langage tels que ChatGPT ou Gemini sont connus sous le nom de LLM (Large Language Models). On les nomme ainsi parce qu’ils sont entraînés sur des volumes massifs de textes en langage naturel. À l’inverse, les modèles TFM ne s’entraînent pas sur du texte, mais sur des données structurées issues de tableaux. Il s’agit d’immenses collections de tableaux hétérogènes à partir desquelles le modèle apprend des motifs généraux (patterns) pouvant ensuite être exploités pour prédire des résultats dans des problématiques d’entreprise très variées.
Jusqu’à présent, lorsqu’une entreprise avait besoin, par exemple, de prédire des impayés, elle utilisait une technologie d’IA fondée sur le machine learning classique (apprentissage automatique). Il s’agit d’un outil relativement simple dont la valeur réside essentiellement dans son entraînement spécifique pour résoudre un problème donné. Si l’entreprise doit également estimer la demande, détecter des fraudes ou évaluer le risque fournisseur, il faut entraîner et concevoir une solution dédiée pour chacun de ces besoins. Cela implique de répéter indéfiniment tout un flux de travail : préparation des données, sélection de l’algorithme (XGBoost, LightGBM, Random Forests…), ingénierie des variables (feature engineering), réglage des hyperparamètres, validation et déploiement. C’est une démarche particulièrement coûteuse en temps et en compétences.
Les modèles TFM sont nettement plus complexes. Tout comme les LLM, ils traversent une phase d’entraînement général très sophistiquée, mais présentent l’immense avantage de constituer un moteur de prédiction généraliste capable de traiter une multitude de tâches. Des modèles comme TabPFN ou TabFM ont prouvé que cette idée n’est pas seulement élégante sur le papier, mais extrêmement efficace en pratique. Dans de nombreux scénarios reposant sur des volumes de données petits à moyens, ces modèles égalent ou dépassent les méthodes classiques de machine learning, et ce, sans qu’il soit nécessaire d’entraîner un modèle spécifique pour chaque tableau. Il suffit de fournir au modèle les lignes de données à prédire dans un contexte unique pour obtenir des prédictions en un seul passage.
Dans la suite de cet article, nous explorerons les fondements des modèles TFM : ce qu’ils sont, en quoi ils se distinguent des LLM, à quoi ils servent concrètement, comment ils s’appliquent aux données réelles de l’entreprise et quelles solutions existent aujourd’hui sur le marché ainsi que dans l’écosystème open-source. L’objectif est d’offrir une vision claire et opérationnelle aux dirigeants, responsables data et professionnels souhaitant comprendre pourquoi les TFM pourraient devenir la pièce manquante de l’IA appliquée aux entreprises.
Comment les données structurées de l’entreprise sont analysées aujourd’hui
La majorité des données stratégiques pour la prise de décision en entreprise se présentent sous forme structurée : des bases de données et des tableaux organisés en lignes et en colonnes. Au cours des deux dernières décennies, l’approche dominante pour exploiter ces données a reposé sur les outils classiques de machine learning (apprentissage automatique).
Le machine learning est un modèle d’intelligence artificielle qui permet de résoudre très efficacement une problématique ciblée grâce à une phase d’entraînement dédiée. Il s’avère particulièrement performant pour éclairer les décisions fondées sur la donnée, constituant ainsi un levier incontournable pour les organisations.
Il existe une large gamme de solutions de machine learning d’entreprise, telles que LightGBM, CatBoost ou XGBoost. Il s’agit de logiciels génériques reposant sur des modèles statistiques, qui doivent être entraînés pour résoudre chaque problème spécifique. De plus, cet entraînement est dit « surveillé », ce qui exige l’intervention d’experts humains à plusieurs étapes clés du processus.
L’entraînement s’effectue en fournissant au système de nombreux exemples et leurs résultats historiques associés. Plus le volume de données fourni lors de cette phase est important, plus les résultats deviennent précis et sophistiqués. Pour résumer, le machine learning consiste à apprendre par l’exemple. Une fois entraîné, le logiciel exploite ces motifs appris (patterns) pour établir des prédictions ou automatiser des prises de décision.
Le principal inconvénient de ces outils réside dans le fait qu’ils doivent être réentraînés spécifiquement pour chaque cas d’usage : prédire les impayés, estimer la demande, détecter les fraudes ou évaluer le risque d’attrition (churn). Le processus d’entraînement implique généralement : l’extraction des données depuis les systèmes internes (ERP, CRM, bases de données), leur nettoyage, la sélection des variables, le choix de l’algorithme adapté à la structure des données et au problème à résoudre, l’entraînement du modèle, sa validation et son déploiement en production. Il s’agit d’un processus coûteux non seulement en temps, mais aussi en compétences spécialisées.
Les solutions de machine learning reposent sur des modèles statistiques sous-jacents, et tous les algorithmes ne se valent pas selon la nature des problèmes rencontrés. Il en résulte un écosystème fragmenté de modèles conçus pour traiter différents types de prédictions.
Dans le monde de l’entreprise, plusieurs algorithmes se sont imposés comme des standards incontournables :
- LightGBM : Un modèle de gradient boosting fondé sur des arbres de décision, optimisé pour la rapidité et l’efficacité sur de grands volumes de données. Le terme boosting indique que le modèle est entraîné de manière itérative afin de corriger les erreurs des étapes précédentes. Le gradient boosting exploite le gradient d’erreur pour orienter chaque modèle successif, rendant le processus plus précis et efficace. LightGBM est particulièrement prisé lorsque la précision et des temps d’entraînement maîtrisés sont critiques, notamment pour la notation de crédit (credit scoring), la prévision de la demande ou la gestion des risques.
- CatBoost : Un autre algorithme de boosting, conçu pour traiter très efficacement les variables catégorielles (non numériques) sans nécessiter d’encodage préalable complexe. Il est très répandu dans les secteurs où les tableaux comportent de nombreuses colonnes textuelles (catégories de clients, de produits ou de contrats) et où la qualité de prédiction est primordiale.
- XGBoost : L’un des pionniers du boosting moderne, largement adopté dans le domaine de la data science et des projets d’entreprise. Bien que des modèles plus récents l’aient dépassé en termes de performances computationnelles, il demeure une référence incontournable au sein de nombreuses équipes analytiques.
Parallèlement à ces algorithmes, les entreprises déploient également des modèles statistiques plus simples (régressions logistiques, random forests, réseaux de neurones de base) combinés à des outils de Business Intelligence (BI) tels que Power BI, Tableau ou Qlik. Ces solutions BI ne sont pas des modèles d’IA en soi, mais elles permettent de visualiser, d’explorer et de segmenter les données structurées, offrant une couche d’analyse descriptive indispensable aux décisions de gestion.
Ces dernières années, l’approche AutoML (apprentissage automatique automatisé) a également gagné du terrain grâce à des plateformes qui automatisent une grande partie de ces étapes : évaluation de plusieurs algorithmes, ajustement des hyperparamètres et sélection du modèle offrant les meilleures performances pour un jeu de données (dataset) donné. Cela a permis à des profils moins spécialisés de construire des modèles prédictifs sans avoir à maîtriser l’ensemble de la complexité technique sous-jacente.
L’inconvénient demeure toutefois le même : chaque nouveau problème exige son propre modèle dédié. Pour chaque nouvelle question métier (quel client risque de faire défaut, quel utilisateur va résilier, quel fournisseur sera en retard, quel sera le volume de ventes le mois prochain), il faut répéter le cycle complet : préparation des données, sélection de l’algorithme, entraînement, validation et déploiement. C’est une démarche puissante, mais coûteuse en temps, en ressources humaines et en maintenance. Les modèles vieillissent, les distributions de données dérivent, les corrélations évoluent, et chaque cas d’usage vient ajouter une brique supplémentaire à la complexité technique globale.
C’est précisément sur ce terrain qu’interviennent les Tabular Foundation Models : non pas pour remplacer du jour au lendemain LightGBM, CatBoost ou XGBoost, mais pour offrir une alternative moderne lorsque l’entreprise recherche rapidité, simplicité et scalabilité sans démultiplier le nombre de modèles à gérer.
Qu’est-ce qu’un modèle TFM ?
Les solutions de machine learning traditionnelles requièrent une intervention humaine experte tout au long de leur processus d’entraînement. En revanche, l’émergence des réseaux de neurones a permis de développer une autre approche : le deep learning (apprentissage profond). Son atout majeur réside dans la capacité d’automatiser entièrement l’apprentissage des représentations complexes lors de l’entraînement. De plus, là où les modèles classiques de machine learning nécessitent des données d’entrée finement structurées, les architectures de deep learning peuvent ingérer des données brutes, non transformées.
Les réseaux de deep learning sont considérablement plus complexes et requièrent une puissance de calcul bien supérieure. Les modèles de langage LLM (tels que ChatGPT ou Gemini) relèvent précisément du deep learning appliqué aux réseaux de neurones. Il en va de même pour les modèles génératifs de son, d’image ou de vidéo.
Par données tabulaires, on désigne l’information organisée sous forme de tableaux, c’est-à-dire structurée en lignes et en colonnes. C’est le format universel des feuilles de calcul (type Excel), des bases de données relationnelles (SQL), des logiciels comptables ainsi que des grands outils de gestion d’entreprise tels que les ERP, les CRM ou les plateformes de BI. Les données tabulaires ne se limitent pas aux valeurs numériques (prix, chiffre d’affaires, nombre de visites, etc.) : elles englobent également les données catégorielles (pays, couleur, segment client), ordonnées (tailles S/M/L, niveau de satisfaction faible/moyen/élevé), temporelles (dates d’achat, horodatages) et booléennes (oui/non, vrai/faux). L’essentiel de la donnée produite et exploitée par une entreprise au quotidien est de cette nature.
Le concept fondateur des TFM repose sur une question simple : si des modèles de deep learning entraînés sur du texte (les LLM) parviennent à rédiger, synthétiser ou raisonner grâce à l’absorption de volumes massifs de contenus, pourquoi ne pas appliquer cette même logique aux données structurées en tableaux ? Un modèle d’IA fondé sur des réseaux de neurones et pré-entraîné sur des données tabulaires est précisément ce que l’on nomme un TFM (Tabular Foundation Model).
Un TFM apprend à classifier, prédire, évaluer des risques ou détecter des anomalies parce qu’il a été exposé, lors de sa phase de pré-entraînement, à une immense variété de structures tabulaires. L’entreprise dispose ainsi d’un modèle unique capable d’interagir avec une multitude de formats de données. Il s’agit donc d’un modèle généraliste pour données tabulaires, en mesure de résoudre des tâches très diversifiées sans qu’il soit nécessaire de l’entraîner spécifiquement pour chaque cas d’usage. Lorsqu’il est confronté à un jeu de données d’entreprise totalement inédit, le modèle identifie instantanément des schémas, des corrélations et des distributions similaires à ceux observés au cours de son entraînement global, lui permettant de générer rapidement la prédiction recherchée.
D’un point de vue opérationnel et stratégique, cette flexibilité fait des TFM l’une des évolutions les plus prometteuses pour la nouvelle génération d’analyse de données structurées en entreprise.
Différences entre TFM et LLM
Les LLM (Large Language Models) et les TFM (Tabular Foundation Models) partagent une architecture commune : ce sont des modèles d’IA entraînés à grande échelle sur des volumes massifs de données, de nature généraliste (capables d’exécuter une grande variété de tâches) et conçus pour servir d’infrastructure analytique face à des problématiques spécifiques. C’est précisément ce qui définit la notion de Foundation Models (modèles fondations) : des modèles socles permettant de bâtir des applications avancées sans avoir à entraîner un système depuis zéro.
Pour autant, TFM et LLM représentent deux philosophies très distinctes de l’intelligence artificielle. Les LLM (comme ChatGPT, Claude ou Gemini) sont entraînés sur d’immenses corpus textuels. Leur objectif principal est d’assimiler la structure et les nuances du langage : la syntaxe, les enchaînements d’idées, la synthèse ou le raisonnement argumenté. Ce sont des modèles conçus pour générer du texte fluide, modéliser une forme de raisonnement abstrait et interagir naturellement avec des utilisateurs humains. Leur valeur ajoutée réside dans la rédaction, l’interprétation et la communication.
Les TFM, à l’inverse, sont entraînés directement sur des tableaux de données. Leur rôle n’est pas de rédiger, mais de prédire des valeurs, de classifier des entrées, d’évaluer des risques ou de détecter des anomalies. Leur périmètre n’est pas celui des mots, mais celui des colonnes, des distributions statistiques, des corrélations et des dépendances numériques. Là où un LLM apprend à compléter une phrase, un TFM apprend à compléter une ligne ou à déduire la valeur probable d’une variable au vu des informations contenues dans les autres colonnes.
Un LLM excelle lorsqu’il s’agit d’expliquer un concept, de rédiger un rapport ou de répondre à des questions complexes. En revanche, si on lui soumet un tableau brut pour prédire une valeur chiffrée, ses performances restent très limitées : le langage naturel n’est pas le medium adapté pour raisonner sur des structures de données mathématiques. Un TFM est spécifiquement optimisé pour ce type d’exercice. Il n’a pas besoin que le tableau soit converti en texte ni décrit en langage courant : il le comprend dans sa forme native.
En réalité, LLM et TFM ne sont pas concurrents, mais parfaitement complémentaires. L’un déchiffre l’entreprise à travers le langage, l’autre à travers ses données structurées. On voit d’ailleurs émerger des architectures hybrides combinant LLM et TFM : la brique LLM sert d’interface utilisateur conversationnelle, tandis que le TFM fait office de moteur de calcul et de prédiction sous-jacent. Ensemble, ils permettent de concevoir des systèmes d’IA qui ne se contentent plus de parler, mais qui prédisent, évaluent et éclairent la décision.
Fondements techniques des TFM
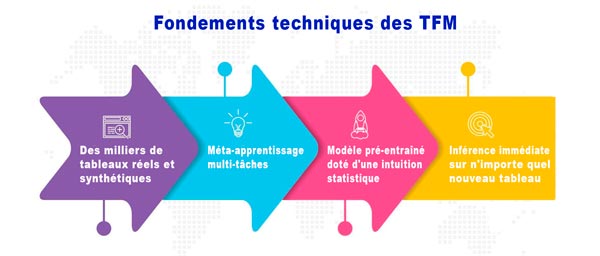
Les TFM ne sont pas des modèles statistiques classiques comme LightGBM ou CatBoost, mais des réseaux de neurones profonds fondés sur l’architecture Transformer, capables d’apprendre des représentations complexes et de passer à l’échelle sur de très grands volumes de données. Par essence, il s’agit de systèmes ayant traversé une longue phase de pré-entraînement profond sur des millions de tableaux réels et synthétiques couvrant une multitude de tâches distinctes.
Chacune de ces tâches peut consister en une classification, une régression, une imputation de valeurs manquantes ou une détection d’anomalies. Le modèle observe en continu l’évolution des distributions, l’interaction des variables et le comportement de la donnée dans des contextes très variés. Au fil de cet entraînement, il développe une véritable « intuition statistique généraliste » lui permettant de s’adapter immédiatement à de nouveaux tableaux sans nécessiter d’apprentissage complémentaire.
L’architecture Transformer, présentée par les chercheurs de Google en 2017 dans l’article fondateur « Attention Is All You Need » (Vaswani et al.), a marqué un tournant décisif dans l’émergence des LLM puis, plus récemment, des TFM. Concrètement, lors du traitement de l’information, le modèle ne prend pas les données telles quelles : il applique un mécanisme dit d’auto-attention (self-attention) pour identifier dynamiquement les chiffres et attributs les plus pertinents à privilégier selon le problème à résoudre. Par exemple, pour prédire une demande, il apprend à accorder un poids supérieur à l’historique des ventes, aux opérations promotionnelles, aux facteurs météorologiques ou aux effets de saisonnalité.
Le résultat de cette transformation s’exprime sous forme de codages vectoriels avancés appelés embeddings, qui intègrent toute l’information contextuelle nécessaire pour lier les variables entre elles de façon fluide. Ainsi, les données ne sont plus de simples chiffres isolés : elles deviennent des éléments contextualisés et interconnectés. Le modèle TFM appréhende d’emblée la structure interne du jeu de données qui lui est soumis, sans aucune intervention manuelle.
Comme on peut l’imaginer, le processus d’entraînement des TFM est particulièrement vaste et transversal. Le modèle extrait les schémas universels des tableaux de données tout comme un LLM assimile les structures universelles de la langue. C’est pourquoi, lorsqu’il reçoit un nouveau tableau, il n’a nul besoin d’être réentraîné : il lui suffit d’appliquer ses connaissances généralistes pour exécuter la tâche demandée.
Un autre élément clé réside dans la simulation de tâches lors de l’apprentissage. Le modèle est confronté à des milliers de cas de figure : tableaux à faible nombre de lignes, jeux de données comportant de très nombreuses colonnes, distributions dissymétriques, variables fortement corrélées, données bruitées ou valeurs manquantes. Pour chaque scénario, il doit résoudre une tâche générée automatiquement. Cet entraînement intensif lui apprend à généraliser, à faire preuve de robustesse et à s’adapter à la réalité des données d’entreprise, qui sont rarement parfaites.
Enfin, les TFM intègrent des mécanismes natifs pour traiter efficacement les petits jeux de données, ce qui constitue l’un des grands défis du machine learning traditionnel. Alors que des algorithmes comme XGBoost ou LightGBM peuvent perdre en précision en présence de peu de lignes, les TFM mettent à profit leur capital de connaissances préalables pour compenser le manque d’historique. Cela en fait des outils précieux dans les secteurs où la donnée est fragmentée, hétérogène ou limitée.
En somme, les Tabular Foundation Models inaugurent une nouvelle catégorie d’intelligence artificielle dédiée aux données d’entreprise. Cette capacité ouvre la voie à une approche beaucoup plus agile, rentable et accessible pour intégrer l’IA au cœur des décisions stratégiques.
Cas d’usage pratiques des TFM
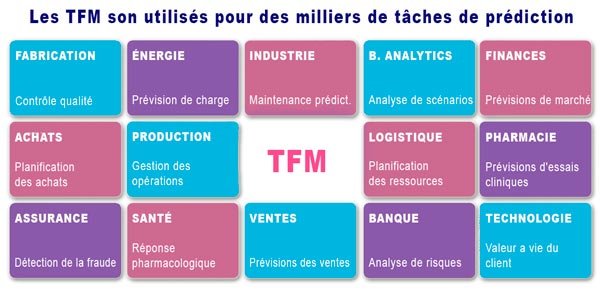
Si les Tabular Foundation Models suscitent un tel engouement au sein du monde des affaires, c’est parce que, au-delà de leur élégance technique, ils répondent à des problématiques très concrètes avec une efficacité inégalée. Les TFM ne sont pas un concept théorique : ce sont des moteurs de prédiction prêts à fonctionner directement sur les tableaux de données déjà existants dans l’entreprise.
L’un des cas d’usage les plus répandus est la prédiction des retards de paiement. Dans des secteurs tels que l’énergie, la logistique ou les services aux entreprises, anticiper les impayés est essentiel pour sécuriser la trésorerie et maîtriser le risque client. Avec un TFM, il suffit de lui fournir un tableau regroupant l’historique de facturation, les caractéristiques des clients, leurs comportements passés et toute autre variable pertinente. Sans aucun entraînement complémentaire, le modèle analyse les corrélations entre colonnes et génère immédiatement une probabilité de retard, y compris lorsque le volume de données disponible est réduit ou hétérogène.
Un autre exemple classique concerne l’attrition client (churn). Les opérateurs de télécommunications, les institutions financières, les compagnies d’assurance ou les services par abonnement dépendent directement de leur capacité a détecter les clients sur el point de partir. Alors que les modèles de machine learning traditionnels exigent des semaines d’entraînement supervisé et de préparation, l’utilisation d’un TFM simplifie considérablement la démarche. Le modèle ingère le tableau d’activité client (utilisation du service, réclamations, ancienneté, interactions) et fournit une prédiction instantanée. L’entreprise peut ainsi déclencher des campagnes de rétention ciblées, plus précises et nettement moins coûteuses.
Les TFM se révèlent également très performants dans l’évaluation du risque fournisseur. Au cœur de chaînes d’approvisionnement complexes, détecter les signaux faibles de défaillance est crucial pour garantir la continuité des opérations. Un TFM peut analyser des tableaux regroupant les historiques de livraison, les indicateurs de qualité, les délais, les incidents passés et les conditions contractuelles, afin d’estimer la probabilité qu’un fournisseur ne tienne pas ses engagements futurs. Cette capacité d’anticipation permet d’adopter des mesures stratégiques adaptées : diversification du panel fournisseurs, renégociation de contrats ou ajustement des stocks de sécurité.
Enfin, l’une des applications les plus transversales reste la prévision de la demande. De la grande distribution à l’industrie manufacturière, toutes les organisations ont besoin d’estimer leurs volumes de ventes à court et moyen terme. Les TFM peuvent traiter des tableaux combinant historiques de ventes, saisonnalité, politiques tarifaires, promotions et facteurs externes. S’ils ne remplacent pas totalement les modèles spécialisés en séries temporelles dans des contextes très complexes, ils constituent une alternative rapide et efficace lorsqu’une entreprise recherche des prédictions agiles sans repartir de zéro.
Dans chacun de ces cas d’usage, la dynamique reste la même : le TFM reçoit un tableau, en décrypte les dépendances internes et génère une prédiction sans nécessiter d’entraînement supplémentaire. Cela réduit drastiquement les délais de déploiement et démocratise l’accès à l’IA appliquée aux données structurées. Ce qui exigeait autrefois des semaines de travail d’ingénierie spécialisée peut désormais s’effectuer en quelques minutes, un gain d’agilité qui, dans le monde des affaires, s’avère hautement stratégique.
Avantages concurrentiels des TFM
L’émergence des Tabular Foundation Models ne constitue pas une simple avancée technique : elle marque une transformation profonde dans la manière dont les entreprises exploitent l’intelligence artificielle sur leurs données structurées.
Le premier avantage, et sans doute le plus structurant, est l’élimination de l’entraînement spécifique par tâche. Dans l’approche traditionnelle, chaque problématique exige la construction d’un modèle sur mesure (préparation des données, choix des algorithmes, réglage des hyperparamètres, validation). Avec un TFM, ce cycle complexe se résume à une étape unique : fournir le tableau et définir la tâche attendue. Cela réduit considérablement les délais de mise en production et permet à des équipes non spécialisées d’intégrer des prédictions avancées directement au cœur de leurs processus métiers.
Le deuxième avantage réside dans leur capacité à traiter efficacement de petits jeux de données, ce qui correspond à la réalité quotidienne de nombreuses organisations. Là où les algorithmes de machine learning classiques nécessitent des volumes massifs de données pour être performants, les TFM s’appuient sur les connaissances acquises lors de leur pré-entraînement sur des milliers de tableaux. Ils peuvent ainsi extrapoler des motifs structurels sous-jacents, même lorsque l’historique disponible est restreint. Cela en fait des outils particulièrement adaptés aux secteurs où la donnée est morcelée, incomplète ou difficile à collecter.
Une autre force majeure réside dans la réduction de la complexité opérationnelle. Le déploiement de modèles de machine learning traditionnels requiert des profils techniques très qualifiés, capables d’extraire, de transformer, de nettoyer et de préparer les données d’entraînement pour chaque projet. Ne nécessitant pas de réentraînement spécifique, les TFM s’intègrent beaucoup plus facilement aux systèmes d’information existants et réduisent la dépendance vis-à-vis d’équipes d’experts dédiées. Cette approche démocratise l’accès à l’IA, permettant aux directions financières, opérationnelles, marketing ou achats de bénéficier de capacités prédictives sans investissements lourds en compétences rares.
Les TFM se distinguent également par leur vitesse d’inférence. Des modèles tels que TabPFN sont capables de générer des prédictions en quelques millisecondes, affranchissant l’organisation des délais d’entraînement inhérents aux méthodes classiques. Cette réactivité ouvre la voie à des usages en temps réel : classification instantanée de clients, évaluation dynamique du risque, détection immédiate d’anomalies opérationnelles ou ajustement agile des prévisions commerciales.
Enfin, il existe un avantage stratégique déterminant : la simplification de l’architecture IA. Plutôt que de gérer et maintenir des dizaines de modèles isolés (un pour chaque besoin métier), l’entreprise peut centraliser son intelligence analytique autour d’un modèle socle unique. De plus, la suppression de la phase d’apprentissage pour chaque nouveau cas d’usage permet de multiplier rapidement les applications concrètes. L’entreprise peut ainsi passer l’IA à l’échelle sans démultiplier la complexité technique, réduisant les coûts de maintenance tout en bâtissant une architecture de données plus cohérente, agile et pérenne.
Au global, ces atouts démontrent pourquoi les TFM s’imposent progressivement comme un pilier de l’IA d’entreprise. Loin d’être une simple évolution algorithmique, ils redéfinissent la façon dont les organisations adoptent, intègrent et généralisent l’intelligence artificielle dans leurs activités stratégiques.
Modèles TFM existants
Bien que les Tabular Foundation Models constituent une catégorie relativement récente dans le paysage de l’IA, l’écosystème actuel offre déjà plusieurs alternatives solides, tant dans le monde académique que sur le marché de l’entreprise. Chacune apporte ses propres nuances en termes d’architecture, de performances et de positionnement, mais toutes partagent la même ambition : résoudre une grande variété de tâches sans nécessiter d’entraînement spécifique.
C’est en 2022 qu’a été développé le pionnier incontesté de la catégorie : le désormais célèbre TabPFN. Il s’agit du premier modèle pré-entraîné spécifiquement sur des données tabulaires, prouvant qu’une architecture généraliste pouvait s’utiliser directement, sans réentraînement, tout en surpassant les méthodes classiques de machine learning. TabPFN est aujourd’hui considéré comme le standard de fait de cette catégorie.
Le développement de TabPFN est l’œuvre d’une équipe de chercheurs menée par Noah Hollmann, aux côtés de Samuel Müller, Katharina Eggensperger et Frank Hutter, tous rattachés à l’Université de Fribourg en Allemagne. Sa mise à disposition en open-source a largement favorisé son adoption et inspiré de nombreuses variantes et extensions.
Pour les organisations souhaitant l’expérimenter, TabPFN est une solution open-source téléchargeable, installable et exécutable en local ou sur un serveur cloud. Les entreprises peuvent l’intégrer directement dans leurs ERP ou CRM internes pour alimenter leurs moteurs de prédiction.
En 2024, la société allemande Prior Labs s’est appuyée sur les fondations de TabPFN pour développer une version industrielle baptisée PriorTab (Prior Labs TabPFN). Ce modèle reprend le socle technique de TabPFN en l’optimisant pour les exigences des grands comptes : stabilité renforcée, support professionnel, intégration facilitée aux pipelines de données et capacités de déploiement avancées. PriorTab a ainsi offert aux entreprises une solution prête pour la production. En 2026, la multinationale allemande SAP a annoncé le rachat de Prior Labs pour un montant dépassant le milliard d’euros.
PriorTab peut être exploité sous forme de service web (SaaS) ou être intégré directement au cœur du système d’information de l’entreprise (ERP, CRM ou plateformes de BI).
Un autre modèle marquant est RTFM (Reinforced Tabular Foundation Model). Cette architecture introduit des techniques d’apprentissage par renforcement afin d’améliorer la capacité du modèle à s’adapter aux évolutions de distributions de données. L’objectif est de permettre au modèle non seulement de traiter tout type de tableau, mais aussi d’apprendre à prendre des décisions optimales dans des environnements où la donnée évolue au fil du temps. RTFM est un projet open-source publié par l’organisation MLFoundations sur GitHub ; il peut donc être téléchargé, installé, modifié et déployé librement.
À la croisée du langage naturel et des tableaux de données apparaît TabLLM, un modèle hybride qui associe les capacités des LLM au raisonnement sur données structurées. Son objectif est de traiter des tâches mixtes : interpréter des instructions en langage naturel, analyser un tableau et générer des prédictions ou des explications textuelles. Bien qu’il ne s’agisse pas d’un TFM pur, son approche multimodale en fait une brique intéressante pour les applications où l’interaction humaine est primordiale. Développé conjointement par le MIT (États-Unis) et l’Université de Munich (Allemagne), TabLLM est open-source et accessible sur son dépôt GitHub, avec une démonstration publique sur tablellm.github.io.
Enfin, d’autres travaux, bien que non qualifiés explicitement de TFM, ont fortement influencé le secteur. C’est le cas de FT-Transformer et de SAINT (Self-Attention and Intersample Transformer), des architectures fondées sur les Transformers et adaptées aux données en tableaux. S’il ne s’agit pas de modèles pré-entraînés généralistes, ils ont démontré que les architectures Transformer pouvaient surpasser les méthodes classiques dans de nombreux scénarios tabulaires. Leur impact conceptuel a été déterminant pour l’émergence de la pré-entraînement sur données structurées.
L’écosystème actuel associe ainsi modèles pionniers, solutions d’entreprise et approches hybrides qui élargissent les perspectives de la catégorie. Si TabPFN demeure la référence, le rythme d’innovation est soutenu et verra naître dans les prochaines années des modèles plus vastes, plus multimodaux et encore mieux intégrés aux systèmes d’information des entreprises. L’essentiel est là : la catégorie est désormais ancrée. Les TFM ne sont plus une curiosité académique, mais des outils opérationnels prêts à transformer le quotidien des entreprises.
Limites actuelles des TFM
Bien que les Tabular Foundation Models représentent une avancée majeure pour l’IA d’entreprise, ils s’inscrivent encore dans un cadre opérationnel comportant certaines limites. À l’instar de toute technologie émergente, les TFM connaissent una phase d’expansion rapide, mais n’ont pas encore atteint la maturité technologique observée dans les modèles de langage ou la vision par ordinateur.
La première contrainte réside dans la dépendance au corpus de pré-entraînement. La valeur d’un TFM dépend directement de la diversité et de la qualité des tableaux observés lors de sa phase d’apprentissage. Si le modèle a été exposé à des structures, des distributions et des tâches très variées, il généralisera efficacement. En revanche, si les données de l’entreprise s’avèrent très spécifiques (données cliniques de haute précision, télémesures industrielles spécialisées ou variables très rares), le modèle peut peiner à appréhender toute la complexité du problème. Dans ces cas de figure, les méthodes de machine learning traditionnelles ou les modèles développés sur mesure (ad hoc) demeurent une meilleure alternative.
Une autre limite importante concerne l’impossibilité de traiter des modalités de données autres que le format tabulaire. Même si certains modèles hybrides commencent à croiser texte et tableaux, les TFM purs ne traitent ni images, ni longues séquences textuelles, ni audio, ni documents complexes. Par conséquent, dans les environnements où les données structurées coexistent avec des informations non structurées, il convient d’associer le TFM à d’autres briques ou de recourir à des architectures multimodales. Les TFM s’imposent sur leur cœur de métier : les tableaux de données.
La question de l’explicabilité constitue également un point d’attention. Les architectures fondées sur les Transformers, bien que particulièrement puissantes, ne possèdent pas la transparence native des arbres de décision classiques du machine learning, dont on peut aisément vérifier les règles, les poids et les parcours de décision. Dans des secteurs fortement réglementés où la traçabilité des choix est critique (finance, santé, assurance), ce manque de lisibilité peut représenter un frein. Des techniques d’explicabilité s’y appliquent progressivement, mais n’atteignent pas encore la clarté des modèles traditionnels.
Sur le plan opérationnel, les TFM peuvent présenter des limites face à des volumes de données très massifs. S’ils s’avèrent particulièrement performants sur des jeux de données de petite à moyenne taille, leur efficacité computationnelle peut diminuer dès lors que le nombre de lignes devint gigantesque. Pour ces scénarios « Big Data », des algorithmes classiques tels que LightGBM ou CatBoost restent plus rapides et mieux armés pour monter à l’échelle.
Enfin, il existe un risque stratégique lié à la jeunesse de cette catégorie. L’écosystème d’outils, la documentation technique, les meilleures pratiques d’ingénierie et les retours d’expérience sont encore en pleine structuration. Les entreprises qui adoptent les TFM aujourd’hui bénéficieront d’un avantage concurrentiel certain, mais elles devront évoluer sur un terrain moins balisé que celui des LLM ou du machine learning classique. La technologie progresse rapidement, mais n’a pas encore atteint la stabilité d’autres domaines de l’IA.
Au global, ces contraintes ne réduisent pas l’intérêt stratégique des TFM : elles en délimitent simplement le périmètre d’action actuel. S’ils constituent des moteurs précieux pour un vaste éventail de problèmes métiers, ils ne représentent pas une solution universelle. Comme pour toute innovation de rupture, leur évolution sera rapide et bon nombre de ces limites s’estomperont au cours des prochaines années. Pour les décideurs, l’enjeu consiste à identifier précisément leur champ d’application actuel afin d’en faire le complément, et non le substitut immédiat, du reste de l’écosystème IA de l’entreprise.
L’avenir des TFM
L’avenir des Tabular Foundation Models s’annonce comme l’une des évolutions les más passionnantes de l’intelligence artificielle appliquée à l’entreprise. S’ils offrent déjà des avantages évidents en termes de rapidité, de simplicité et de capacité de généralisation, leur feuille de route vise un objectif encore plus ambitieux : devenir le socle fondamental sur lequel reposeront les systèmes de décision automatisés des organisations.
La première tendance lourde concerne l’enrichissement des phases de pré-entraînement. À l’instar des modèles de langage qui ont gagné en taille et en diversité de corpus, les TFM évolueront vers des architectures plus vastes, entraînées sur des collections massives de tableaux issus de multiples secteurs d’activité. Cette montée en échelle améliorera la précision globale tout en renforçant la capacité d’adaptation à des domaines très spécialisés. Forts de cette diversité, les TFM généraliseront avec une plus grande finesse dans la santé, l’industrie, l’énergie ou la finance, où les données structurées possèdent des particularités très marquées.
Une autre voie d’évolution majeure sera la multimodalité. Bien que les TFM actuels se concentrent sur les structures tabulaires, nous verrons émerger des modèles capables de croiser naturellement tableaux, texte libre, séries temporelles, images et signaux capteurs. Cela permettra de résoudre des problématiques complexes où l’information structurée cohabite avec des données non structurées : dossiers médicaux, audits financiers, inspections industrielles ou évaluations de risques intégrant métriques et documents. La frontière entre TFM et LLM s’estompera progressivement pour laisser place à des modèles hybrides maîtrisant aussi bien le langage que les données chiffrées.
Des progrès significatifs verront également le jour en matière d’explicabilité et d’interprétabilité, un enjeu crucial pour les secteurs réglementés. La capacité d’un TFM à justifier ses prédictions, en mettant en lumière les variables clés, leurs interactions et les schémas détectés, sera déterminante pour son adoption dans la banque, l’assurance, la santé ou le secteur public. Des outils dédiés permettront de visualiser le raisonnement interne du modèle, lui apportant la transparence qui fait la force des méthodes classiques à base d’arbres.
Sur le plan opérationnel, les TFM s’intégreront de manière encore más fluide au cœur des systèmes d’information. Nous verrons apparaître des modèles conçus pour fonctionner au sein même des infrastructures de données des entreprises, intégrés aux flux où la donnée est créée, transformée et consommée. Les prédictions pourront ainsi être générées en continu, de façon automatique et contextualisée, sans intervention humaine. Les TFM deviendront de véritables moteurs de décision embarqués au cœur des processus métiers.
Enfin, une tendance stratégique majeure marquera la prochaine décennie : l’automatisation complète du cycle de vie des données tabulaires. Les TFM pourront prendre en charge la détection d’anomalies de collecte, la sélection automatique des variables pertinentes, l’adaptation continue aux dérives de distribution ou la génération de recommandations opérationnelles. En d’autres termes, les TFM ne se contenteront plus de prédire : ils recommanderont ou déclencheront directement les actions les plus adaptées aux objectifs de l’entreprise.
Au global, l’avenir des Tabular Foundation Models dessine une IA d’entreprise plus accessible, mieux intégrée et plus autonome. Leur évolution ne transformera pas seulement la façon dont les organisations exploitent leurs données en tableaux : elle redéfinira en profondeur le rôle de l’intelligence artificielle dans la prise de décision stratégique. Ce qui est aujourd’hui une technologie prometteuse deviendra demain un composant essentiel de l’infrastructure numérique des entreprises.
Conclusions
Les Tabular Foundation Models représentent l’un de ces points de bascule technologiques qui, sous une apparence plutôt sobre, sont appelés à transformer en profondeur la façon dont les entreprises exploitent l’intelligence artificielle. Pendant des années, l’IA a progressé de manière spectaculaire dans le traitement du langage, la vision par ordinateur ou la génération de contenus, alors même que l’essentiel de la valeur économique réelle des organisations reste concentré dans leurs tableaux de données. Les TFM sont nés précisément para éclairer ce territoire et en faire un espace où l’IA peut se déployer avec rapidité, précision et simplicité.
Comme nous l’avons analysé, les TFM ne constituent pas une simple évolution incrémentale des algorithmes classiques, mais inaugurent une nouvelle catégorie à part entière au sein de l’écosystème IA. Leur capacité à fonctionner sans entraînement spécifique (zero-shot), leur efficacité sur de petits jeux de données, leur vitesse d’exécution et leur facilité d’intégration en font des leviers d’une valeur inestimable pour les entreprises en quête de résultats rapides, affranchies des projets de machine learning longs et coûteux. Dans un environnement économique où l’agilité importe tout autant que la précision, les TFM offrent un compromis particulièrement performant.
Face aux modèles de langage (LLM), nous avons constaté qu’il n’existe aucune concurrence, mais une complémentarité évidente. Là où les LLM interprètent, expliquent et communiquent, les TFM prédisent, évaluent et éclairent la décision. Ensemble, ils permettent de concevoir des systèmes d’IA plus complets, où le langage naturel et les données structurées cohabitent pour fournir des réponses plus intelligentes et opérationnelles. Cette synergie sera clé au cours des prochaines années, notamment avec l’émergence de modèles hybrides traitant simultanément texte et tableaux.
Naturellement, les TFM conservent des limites : leur dépendance aux données de pré-entraînement, l’absence de multimodalité complète, une explicabilité encore en structuration et des performances inégales sur les très grands volumes de données (Big Data). Toutefois, ces contraintes ne représentent pas des obstacles infranchissables, mais plutôt les axes d’évolution d’une technologie en plein essor. La trajectoire des TFM dessine des modèles plus vastes, plus transparents, mieux intégrés et plus autonomes.
En somme, les Tabular Foundation Models offrent aux décideurs une opportunité majeure de repenser l’exploitation de leurs données structurées. Ils démocratisent l’accès à l’IA, réduisent la complexité opérationnelle et accélèrent les prises de décision fondées sur la prédiction. Ils constituent, en quelque sorte, la pièce manquante pour intégrer l’intelligence artificielle au cœur des processus métiers sans friction. Bien que nous n’en soyons qu’aux débuts, tout indique que les TFM s’imposeront comme l’une des technologies structurantes de la prochaine décennie dans l’IA appliquée aux entreprises.
En savoir plus
Cet article a exploré les fondements des modèles TFM : leur nature, leurs différences avec les LLM, leurs cas d’usage pratiques, leur application aux données d’entreprise et les solutions disponibles sur le marché et dans l’écosystème open-source. Nous espérons que cette lecture vous a été utile. Si vous recherchez de l’inspiration ou souhaitez approfondir ces thématiques, ce blog propose de nombreux autres contenus dédiés. N’hésitez pas à utiliser le moteur de recherche situé en haut de page.
Bibliographie
Bien que les contenus de ce blog aient une vocation pédagogique et informative, la vérification des sources reste une démarche que nous abordons avec la plus grande rigueur. Néanmoins, s’agissant d’une publication à but non lucratif fonctionnant de manière sobre, nous ne sommes pas en mesure de consacrer le temps nécessaire au référencement exhaustif de chaque donnée présentée. Pour les lecteurs souhaitant vérifier nos références, voici quelques-unes des principales sources consultées dans le cadre de cet article :
- Livre : Hands-On Machine Learning with Scikit-Learn, Keras & TensorFlow. Auteur : Aurélien Géron. Éditeur : O’Reilly Media. ISBN : 978-1492032649. Explique clairement les bases du machine learning moderne, notamment les arbres de décision, le boosting et les réseaux de neurones, qui servent de socle conceptuel pour comprendre le saut évolutif apporté par les TFM.
- Livre : The Hundred-Page Machine Learning Book. Auteur : Andriy Burkov. Éditeur : Andriy Burkov. ISBN : 978-1999579500. Une introduction concise et accessible au machine learning, idéale pour les lecteurs non spécialistes souhaitant appréhender le contexte précédant l’émergence des TFM.
- « TabPFN: A Transformer That Solves Small Tabular Classification Problems in a Second ». arXiv (2023), Noah Hollmann, Samuel Müller, Katharina Eggensperger, Frank Hutter. https://arxiv.org/abs/2207.01848. Article fondateur introduisant TabPFN et démontrant qu’un modèle pré-entraîné peut surpasser les méthodes classiques sur de petits tableaux.
- « TabPFN‑2.5: Advancing the State of the Art in Tabular Foundation Models ». arXiv (2025–2026), Léo Grinsztajn et al. https://arxiv.org/abs/2511.08667. Présente des améliorations substantielles en termes de capacité, de performances et de passage à l’échelle, consolidant TabPFN comme référence industrielle.
- « TabPFN‑3: Technical Report ». arXiv (2026), Léo Grinsztajn et al. https://arxiv.org/abs/2605.13986. Étend TabPFN à des jeux de données atteignant jusqu’à 1 million de lignes et explore des capacités multimodales, traçant l’avenir des TFM.
- « TabPFN: One Model to Rule Them All? ». arXiv (2025), Qiong Zhang, Yan Shuo Tan, Qinglong Tian, Pengfei Li. https://arxiv.org/abs/2505.20003. Analyse critique et détaillée du fonctionnement interne de TabPFN, axée sur son interprétation comme inférence bayésienne approchée.
- Dépôt GitHub de TabPFN. https://github.com/automl/TabPFN. Code officiel, documentation, démonstrations et notebooks permettant d’expérimenter directement avec le modèle.
- Page produit de PriorTab. https://priorlabs.ai. Informations sur la version entreprise de TabPFN, optimisée pour la production et le déploiement en entreprise.
- AutoML Benchmarks (OpenML). https://www.openml.org. Ensemble de jeux de données utilisés pour évaluer TabPFN et le comparer aux modèles classiques tels que XGBoost, LightGBM et CatBoost.
- Documentation de LightGBM. https://lightgbm.readthedocs.io. Référence technique sur l’un des modèles de machine learning tabulaire les plus utilisés, utile pour contextualiser les atouts des TFM.
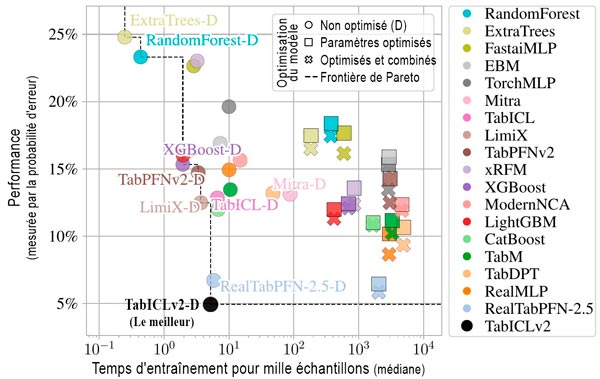
- « TabICLv2: A better, faster, scalable, and open tabular foundation model ». Jingang Qu, David Holzmüller, Gaël Varoquaux, Marine Le Morvan. (2026). https://arxiv.org/abs/2602.11139.
- « Tabarena: A living benchmark for machine learning on tabular data ». Erickson, N., Purucker, L., Tschalzev, A., Holzmüller, D., Desai, P. M., Salinas, D., & Hutter, F. (2025). https://arxiv.org/abs/2506.16791.
- « Developing Foundation Models for Real-World Tabular Data ». Marta Garnelo, Wojciech Marian Czarnecki. (2026). Lien Whitepaper.
- « Representation Learning for Tabular Data: A Comprehensive Survey ». Lien Résumé ADS. Propose une typologie complète et à jour (2025) des méthodes d’apprentissage de représentations pour données tabulaires, les classant en modèles spécialisés, transférables et généraux (les TFM).
- « TabICL: A Tabular Foundation Model for In-Context Learning on Large Data ». https://ar5iv.labs.arxiv.org/html/2502.05564. Présente TabICL, un modèle traitant de la scalabilité de l’apprentissage en contexte pour les grands ensembles de données (jusqu’à 500 000 échantillons), surpassant TabPFNv2 en rapidité et les méthodes traditionnelles sur de très grands tableaux.
- « Accurate Predictions on Small Data with a Tabular Foundation Model (TabPFN) ». Nature (2024). https://www.nature.com/articles/s41586-024-08347-9. Publié dans la revue Nature, cet article fondateur présente TabPFN (Prior-Data Fitted Networks) en démontrant des performances prédictives remarquables sur des jeux de données restreints à moyens.
- « Panel on Neural Relational Data: Tabular Foundation Models, LLMs… or Both? ». ACM DL (2025). https://dlnext.acm.org/doi/abs/10.14778/3750601.3760519. Table ronde d’experts débattant de l’avenir de la gestion de données, opposant la philosophie des TFM à celle des LLM.
- « Interpretable Tabular Foundation Models via In-Context Kernel Regression ». https://ar5iv.labs.arxiv.org/html/2602.02162. Traite de l’opacité des TFM en introduisant KernelICL, un cadre remplaçant la couche finale de prédiction par des fonctions noyau (ex. gaussiennes) afin d’assurer la transparence des résultats.